Enquêtes FinScope · Afrique de l'Est
Inclusion financière
Kenya · Rwanda · Tanzanie · Ouganda · 2016-2018
23 524 réponses à une enquête. Une question : qui possède un compte bancaire, et peut-on le prédire ?
Mesuré le 30 septembre 2026 · Random Forest · AUC 0,81
Part des répondants qui ont un compte bancaire
- Kenya6 066 répondants25,1 %
- Rwanda8 734 répondants11,5 %
- Tanzanie6 570 répondants9,2 %
- Ouganda2 101 répondants8,6 %
L'histoire · 1
L'emploi et l'éducation d'abord
Avoir un compte dépend moins du pays que de la situation de la personne.
Fig. 01
financial_inclusion_clean.csv
Par type d'emploi
- Salarié du public77,5 %
- Salarié du privé54,2 %
- Indépendant13,2 %
- Agriculture et pêche11,7 %
- Emploi informel7,9 %
- Sans revenu2,1 %
Fig. 02
financial_inclusion_clean.csv
Par niveau d'éducation
- Formation professionnelle57,0 %
- Enseignement supérieur51,2 %
- Enseignement secondaire23,3 %
- Enseignement primaire8,5 %
- Sans instruction3,9 %
77,5 % des salariés du public ont un compte, contre 7,9 % des personnes en emploi informel. Sans instruction, la part tombe à 3,9 %.
L'histoire · 2
Le piège de la précision
Le modèle du dépôt a été entraîné sur toutes les données, sans mesure de performance. Évalué ici sur un jeu de test mis de côté, il a l'air excellent. Il ne l'est pas.
Seuls 14,1 % des répondants ont un compte : un modèle qui ne prédit jamais « oui » a déjà raison 85,9 % du temps. Le bon indicateur est le rappel : parmi les personnes qui ont un compte, le modèle n'en retrouve que 39,4 %.
- Précision globale
- 86,6 %
- Rappel sur « oui »
- 39,4 %
- personnes avec compte retrouvées
- Précision sur « oui »
- 53,5 %
- AUC
- 0,815
Jeu de test stratifié de 4 697 réponses (662 avec compte), mesuré le 30 septembre 2026.
L'histoire · 3
L'identifiant qui gonflait le score
Dans la première version, la colonne uniqueid était encodée comme une variable : le modèle apprenait à partir d'identifiants de répondants, qui ne disent rien d'une personne. Elle est maintenant exclue.
| Modèle | Variables | Rappel « oui » | Précision « oui » | AUC |
|---|---|---|---|---|
| Première version, avec l'identifiant | 8 782 | 29,2 % | 72,0 % | 0,850 |
| Version actuelle, sans l'identifiant | 47 | 39,4 % | 53,5 % | 0,815 |
Sans l'identifiant, l'AUC passe de 0,85 à 0,81 : une partie du score venait d'un signal que le modèle n'aurait pas dû avoir. Il retrouve en revanche davantage de personnes avec un compte. Mêmes données nettoyées, même jeu de test, mêmes paramètres.
Sous le capot
Le pipeline
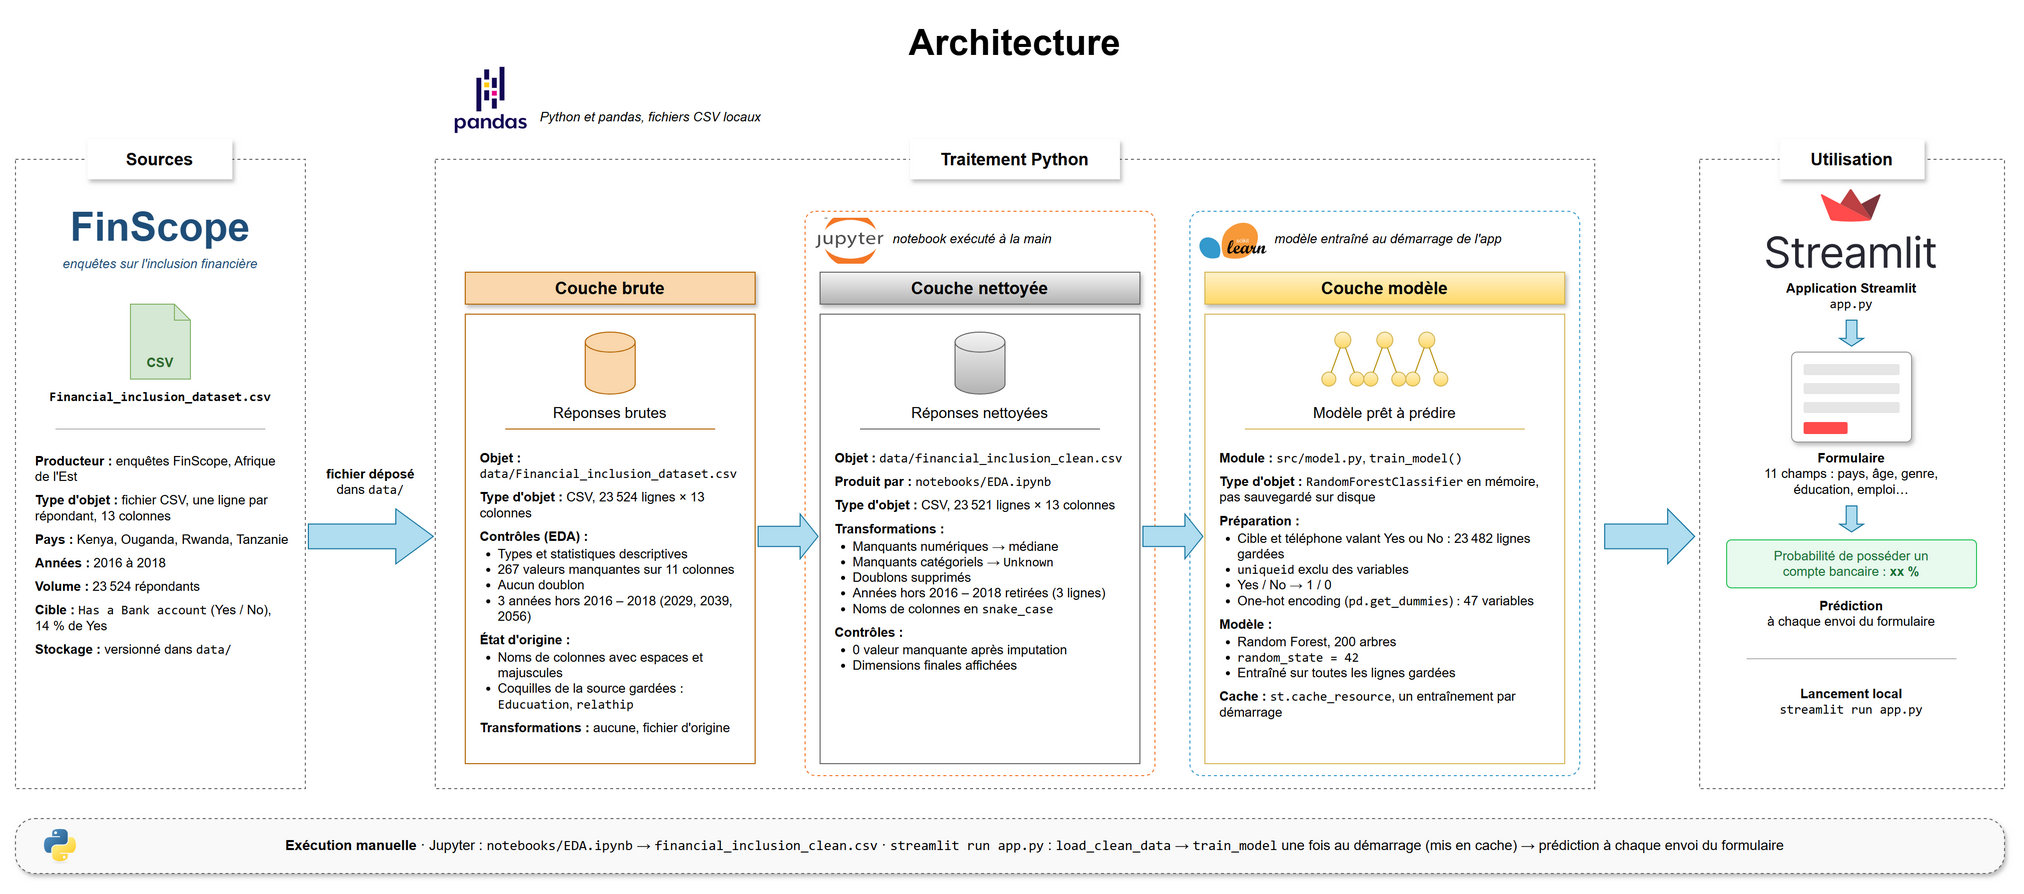
Un CSV brut, une analyse exploratoire dans un notebook, un CSV nettoyé, puis un modèle entraîné au démarrage d'une application Streamlit.
01 · Source
CSV FinScope
23 524 réponses, 13 colonnes
02 · Exploration
notebooks/EDA.ipynb
profilage, manquants, doublons, distributions
03 · Nettoyage
CSV nettoyé
267 valeurs manquantes remplacées, 3 lignes hors période retirées
04 · Modèle
src/model.py
Random Forest, 200 arbres, 47 variables
05 · Usage
app.py
formulaire Streamlit, probabilité en temps réel
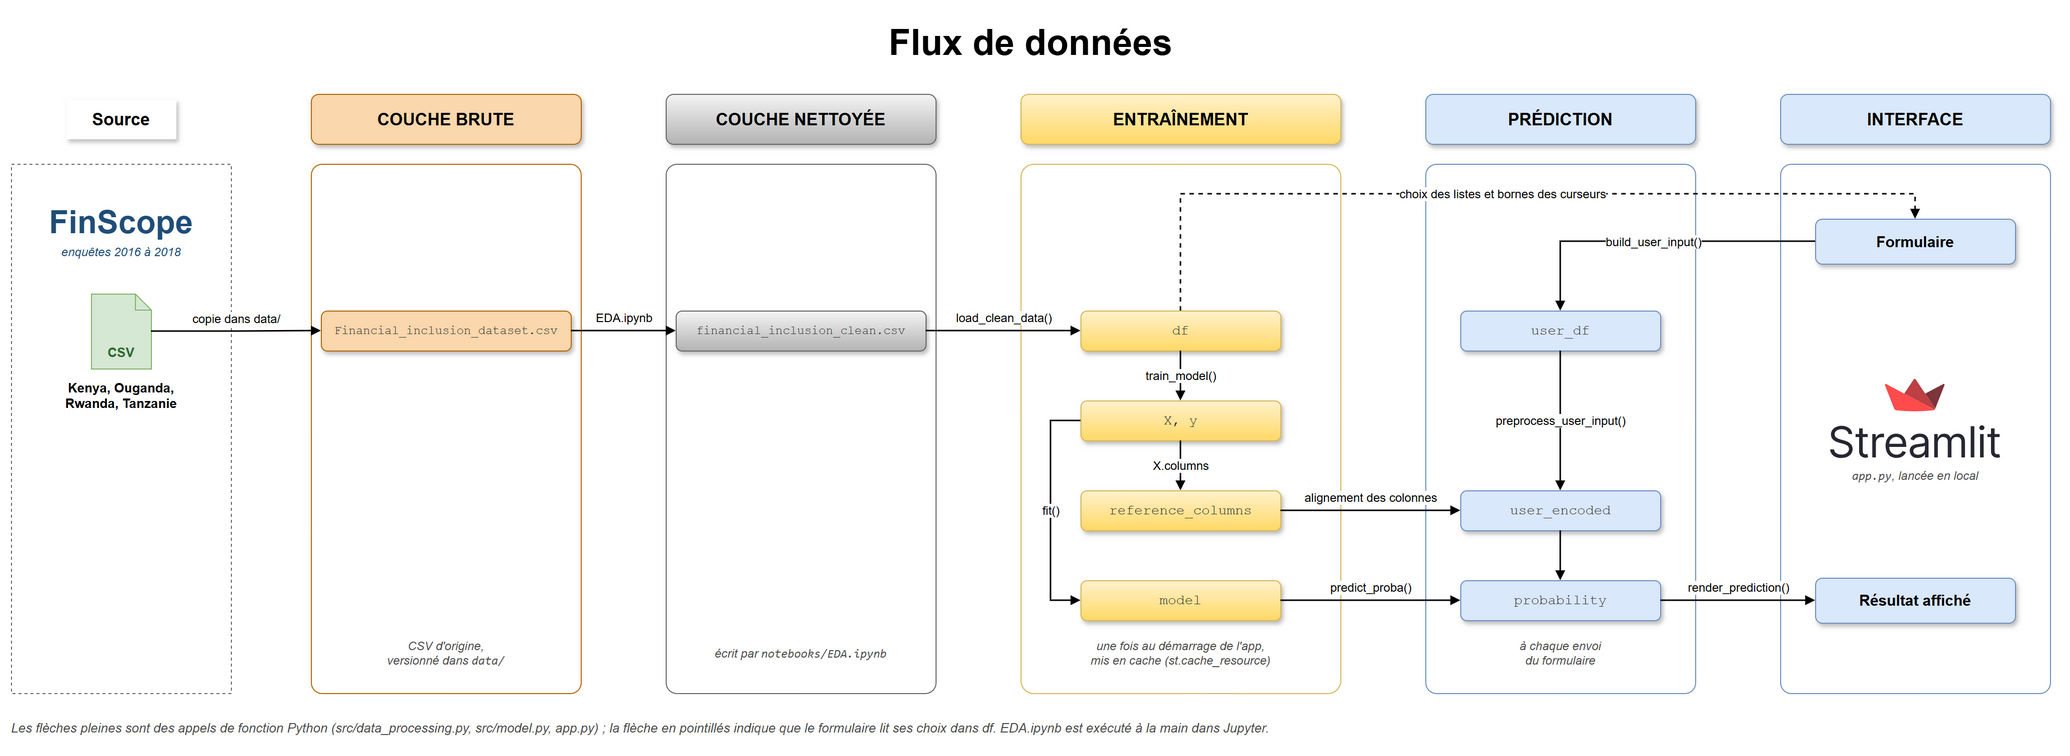
§ 01Architecture et flux de donnéesLes schémas du dépôt, de la source à l'application
§ 02Le datasetEnquêtes FinScope, quatre pays, 2016 à 2018
Réponses aux enquêtes FinScope menées au Kenya, au Rwanda, en Tanzanie et en Ouganda : pays, année, type de localisation, accès au téléphone, taille du foyer, âge (moyenne de 38,8 ans), genre, relation avec le chef du foyer, situation matrimoniale, niveau d'éducation, type d'emploi, et la cible : la possession d'un compte bancaire.
§ 03La qualité3 défauts corrigés, 4 points restants
Le nettoyage remplace les 267 valeurs manquantes (médiane pour les nombres, « Unknown » pour les catégories), retire les lignes hors période et normalise les noms de colonnes : 23 521 lignes, aucune valeur manquante, aucun doublon. Trois défauts relevés à l'exploration ont été corrigés :
| Corrigé | Détail |
|---|---|
| Valeurs manquantes restées en place | l'imputation par fillna(inplace=True) sur une copie de colonne ne s'appliquait plus sous pandas 3 : les 267 valeurs manquantes restaient. Les colonnes sont maintenant réaffectées : 0 manquant |
| Années hors période d'enquête | 2029, 2039 et 2056, une ligne chacune, alors que l'enquête couvre 2016 à 2018 : les 3 lignes sont retirées |
| Identifiant parmi les variables | uniqueid encodé en 8 735 colonnes one-hot : exclu du modèle, qui passe de 8 782 à 47 variables |
Le profilage du fichier nettoyé montre ce qu'il reste à traiter :
| Reste à traiter | Détail |
|---|---|
| Cible inconnue | 36 lignes « Unknown » pour la possession d'un compte, écartées au moment de l'entraînement |
| Pays inconnu | 14 lignes dont le pays manquait, remplacé par « Unknown » comme les autres catégories |
| Niveau d'éducation « 6 » | une modalité sans libellé, à côté des niveaux nommés |
| Noms de colonnes d'origine | fautes conservées après le passage en snake_case : level_of_educuation, the_relathip_with_head |
§ 04Les décisions techniquesModules séparés, Random Forest, Streamlit
- Séparer les responsabilités
- Chargement et prétraitement dans src/data_processing.py, entraînement dans src/model.py, interface dans app.py.
- Random Forest
- Un modèle robuste aux variables catégorielles encodées, sans mise à l'échelle, avec des paramètres fixés pour être reproductible.
- Aligner la saisie sur le modèle
- Le formulaire est encodé de la même façon que les données d'entraînement, puis réaligné sur leurs colonnes.
- Une interface en français
- Libellés traduits dans le formulaire, pour un usage direct par un public non technique.
§ 05Ce que j'amélioreraisÉvaluer, contrôler, entraîner une fois
- Évaluer le modèle. Séparer un jeu de test et publier le rappel et l'AUC, pas seulement la précision, trompeuse sur des classes aussi déséquilibrées.
- Transformer les corrections en contrôles automatiques, relancés à chaque exécution : aucune valeur manquante, années de 2016 à 2018, identifiant absent des variables. Puis traiter ce qui reste : modalité « 6 », pays et cibles inconnus.
- Entraîner une fois, pas à chaque démarrage. Sauvegarder le modèle entraîné plutôt que de le réentraîner à chaque lancement de l'application.